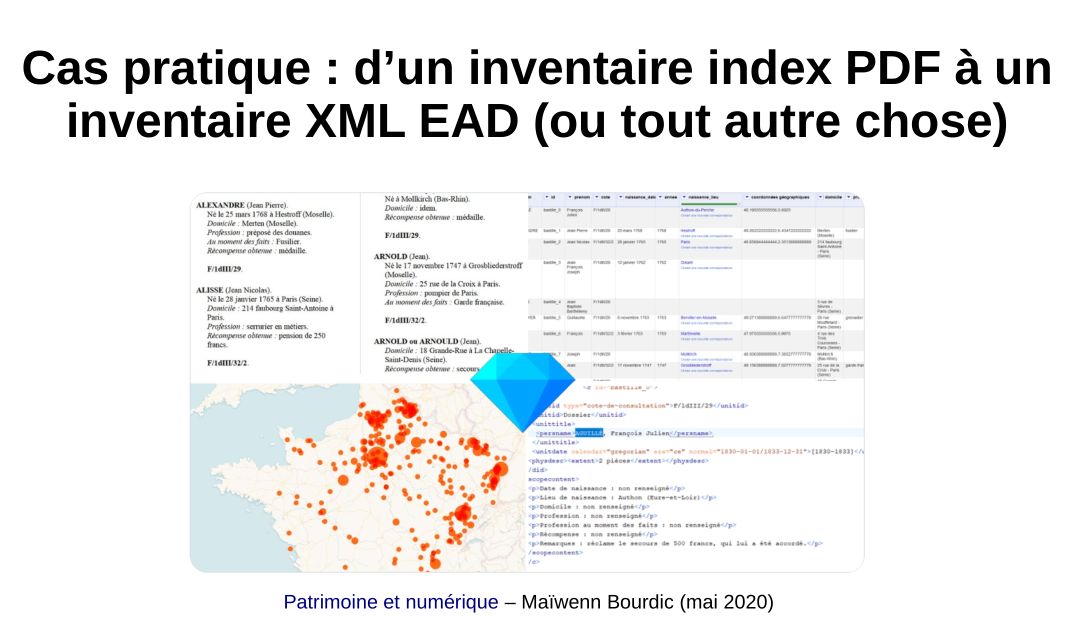
À l'occasion d'un récent encodage d'inventaire parfait pour l'exercice et après plusieurs formations partielles et expresses tronquées faute de temps, voici enfin le pas à pas illustré et détaillé du cheminement permettant de passer d'un magnifique inventaire PDF très textuel à un inventaire électronique publiable sur un portail d'archives.
L'inventaire PDF initial faisait 55 pages et concerne un peu plus de 700 descriptions de dossiers, mais le cheminement est identique (et a été éprouvé) pour des contenus de milliers de notices.
Il ne s’agit pas ici de fournir la meilleure ou la plus rapide méthode pour arriver au but. Tout dépend du contenu initial, de la maîtrise de l’outil OpenRefine, et de la façon de penser et de construire des sous-ensembles auxquels appliquer des transformations en masse. Ce cas pratique vise à donner des idées de méthodes et de logiques applicables pour l'encodage et la normalisation de contenus volumineux et sériels.
Enfin, loin de moi l'idée de laisser entendre que l'encodage XML EAD est la solution idéale pour ce genre de données. Les données nettoyées et enrichies dans OpenRefin sont d'ailleurs exportables en différents formats (CSV, JSON, HTML, etc.) et donc facilement réinjectables dans des structures informatiques. Néanmoins, le XML EAD est à l'heure actuelle souvent le seul outil de publication en ligne de contenus archivistiques. Et mieux vaut un inventaire électronique normalisé et interrogeable en recherche qu'un fichier PDF ou Word noyé au fin fond d'un serveur en local ou en ligne.
Le cas pratique se découpe en 4 grandes parties :
1. Transformation du contenu en tableur structuré (diapos 4 à 27) : c'est la phase la plus longue (environ deux grosses heures sur le jeu de données utilisé) ;
2. Harmonisation et enrichissement (diapos 28 à 41) : environ une heure pour homogénéiser le contenu, corriger les coquilles voire enrichir les données d'origine ;
3. Exporter en XML EAD (diapos 42 à 46) : selon l'aisance avec le schéma XML EAD, pas plus de 15 et 30 minutes
4. Des pistes pour aller plus loin... (diapos 47 à 50) : pour le plaisir, quelques idées pour aller encore plus loin, en indexant en masse à partir de référentiel, en utilisant les données pour faire des statistiques ou de la réconciliation avec Wikidata pour enrichir les contenus.
Côté ressources, je renvoie vers le tutoriel pense-bête OpenRefine, "Excel aux hormones" publié sur ce site et régulièrement mis à jour, ainsi que les sites suivants :
Profitons de ces temps de confinement pour réveiller (déconfiner ?) ce site un peu endormi... alors même les activités numériques parallèles ne manquent pas ! Ces dernières années, j'ai notamment investi Wikidata à travers différents projets archivistico-professionnalo-personnels :
consolidation de données pour une liste d'autorité des architectes diocésains, à la fois en récupérant des informations de Wikidata (données biographiques, identifiant BNF, Leonore, etc.) et en y rajoutant de nouveaux éléments (données biographiques manquantes, fonctions, ajout de signatures) (Archives nationales ; voir la requête en ligne sur Wikidata) ;
ajout en masse des identifiants RSN manquants pour les services d'archives à partir des données disponibles sur data.culturecommunication, création en masse des services d'archives communaux et régionaux inexistants
création d'éléments et insertion des métadonnées descriptives de documents figurés téléversés sur Commons (travaux de restauration des cathédrales au XIXe siècle (Archives nationales ; voir la requête en ligne sur Wikidata) ;
Umapest un logiciel de cartographie opensource qui utilise les fonds de cartes OpenStreetMap. Accessible directement sur Internet, il permet de créer et partager toute sorte de cartes, de les enregistrer en ligne et d'importer / exporter les données dans des formats ouverts.
Rechercher/remplacer par, faire des filtres, des tris, voire des macros, c'est sympa, mais souvent très long, fastidieux, et parfois frustrant. Alors jetez-vous sur OpenRefine, "Excel aux hormones" selon l'excellente expression d'Antoine Courtin.
Testé et adopté à l'occasion du datasprint des archives, OpenRefine permet de faire extrêmement vite (et très bien) des nettoyages, des harmonisations et des enrichissements de données, en masse !
Même si l'essentiel de la documentation est en anglais, l'outil est utilisable en français et manipulable assez rapidement. Point non négligeable quand on travaille en collectivité sur des réseaux informatiques très verrouillés : il suffit d'avoir téléchargé le logiciel sur une clé USB, de glisser le répertoire sur son ordinateur et d'ouvrir le fichier exécutable pour l'utiliser (même sans droit administrateur).
Pour ma part, je me suis d'abord contentée de visualiser les 3 vidéos ci-dessous (en anglais, mais elles valent le coup d'oeil, juste pour avoir une idée de l'immensité des possibles)... avant de me jeter dans le bain, de tâtonner et de chercher au fur et à mesure des besoins.
Pour l'histoire rapide, l'outil a initialement été développé en open-source, puis soutenu par Google (d'où l'existence de versions Google Refine, de 2010 à 2012) puis de nouveau entièrement ouvert.
En plus d'être un peu didactique, le tutoriel ci-dessous est surtout un pense-bête personnel mais partagé, amené à s'enrichir régulièrement, pour garder sous la main les formules plus ou moins alambiquées trouvées parfois au bout de longues recherches et d'essais plus ou moins fructueux.
Ce tutoriel a été rédigé en 2017, à une période où ce réseau social avait encore, à mon sens, un intérêt dans la médiation numérique du patrimoine. Ce n'est plus le cas depuis 2022, du fait des évolutions de l'outil, sa gouvernance politique et économique, ses règles de confidentialité, ses algorithmes, et les interactions qui peuvent y rester avec les publics qu'on cherche vainement à atteindre.
Le billet a dont été dépublié. Une version archivée est visible en PDF et sur Internet.archive
Le numérique c’est fantastique (et non dramatique), surtout quand on travaille dans le domaine du patrimoine.
« C’est compliqué… ». « Je n’ose pas… ». « Je ne sais pas comment faire… »
Nul besoin d’années de code pour se simplifier la vie et le boulot sur un ordinateur. Archiviste et formatrice sur les outils et la médiation numérique, j'ai créé en 2015 ce blog pour partager et diffuser auprès des acteurs des archives et du patrimoine des tutoriels et des outils simples, pratiques et gratuits.
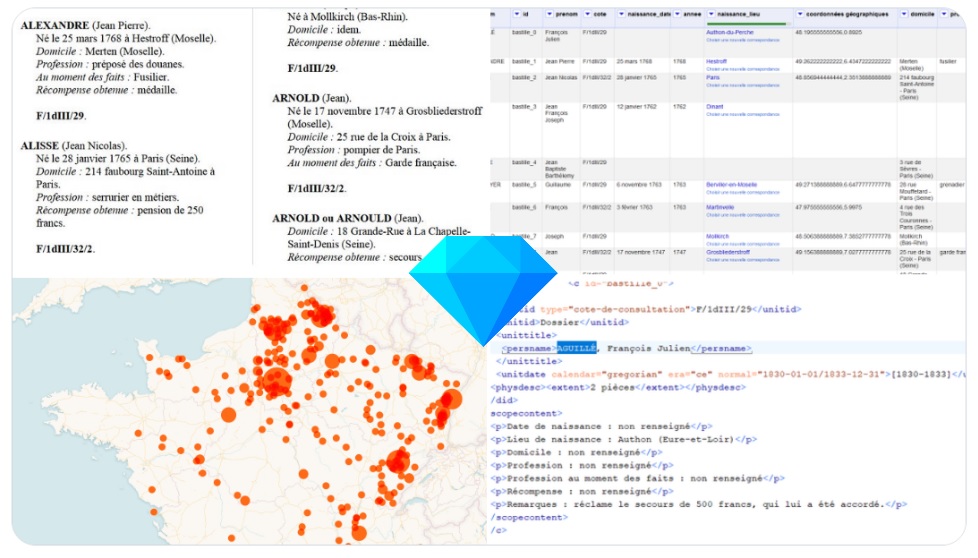 À l'occasion d'un récent encodage d'inventaire parfait pour l'exercice et après plusieurs formations partielles et expresses tronquées faute de temps, voici enfin le pas à pas illustré et détaillé du cheminement permettant de passer d'un magnifique inventaire PDF très textuel à un inventaire électronique publiable sur un portail d'archives.


 Rechercher/remplacer par, faire des filtres, des tris, voire des macros, c'est sympa, mais souvent très long, fastidieux, et parfois frustrant. Alors jetez-vous sur